
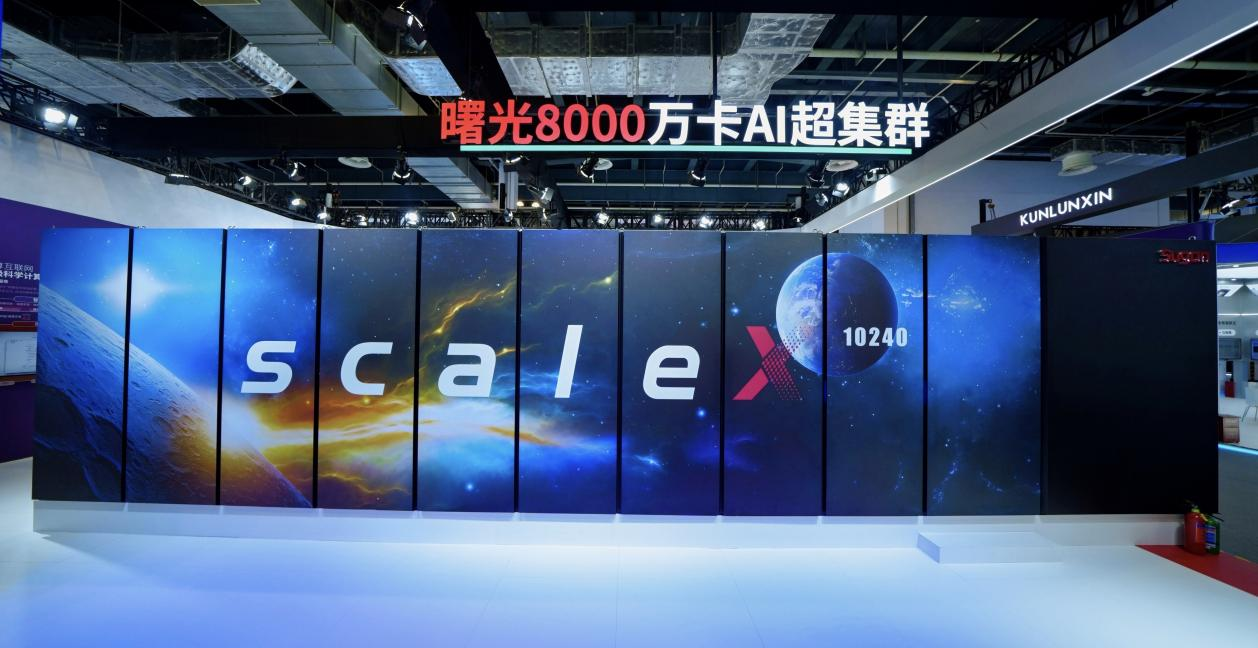
在今年的世界人工智能大会(WAIC 2026),一个细节引起关注:中国首个全国产十万卡AI超集群——曙光8000(登峰)真机首次面向全球公开亮相中国股票配资企业,并入选“镇馆之宝”。
一同入选的还有中兴通讯OEX超节点,它能使硬件互联成本降低80%,突破传统GPU集群互联带宽瓶颈。
两款超集群/超节点同时入选,这在“镇馆之宝”中尤其瞩目,这背后折射的趋势是,当下全球算力竞争,已从单一芯片性能的比拼,转向体系化、系统化、集群化的算力基础设施综合竞争,包括华为、中科曙光、摩尔线程、壁仞、燧原、昆仑芯、超聚变、沐曦、燧原等厂商,纷纷推出了1024卡超节点、256GPU(图形处理器)单层网络全互联及10万卡集群或公布最新超节点计划。这些新的“大国重器”,为我国通用大模型训练、推理提供了国产算力支撑。
从秀芯片到秀机柜、秀集群
过去几年,AI算力的竞争逻辑很简单——谁的芯片算力强,谁就赢。
但是,当模型参数从千亿迈向数万亿(超大参数)、Agent等应用场景要求百万级上下文长度(超长文本)、推理和训练都需要成千上万张GPU协同工作(超大集群),一个新的挑战出现了:
仅凭单张GPU的算力性能,已难以独立承载上述复杂任务。比如,传统集群在规模扩大后,芯片之间的数据传输等待会吃掉30%到50%的计算资源,算力没法被充分利用。
如何实现海量GPU高效协同运行,使之如同一台一体化超级计算机开展工作,正是超节点架构着力破解的核心难题。
通俗来说,以前机房里的服务器,像是一个个单打独斗的打工人,各算各的。而“超节点”,就是用超高速网络,把成百上千张AI芯片紧紧连在一起,变成一个拥有“超级大脑”的数字巨人。
不少硬核算力企业已不秀单颗芯片,而是秀机柜、秀集群。
华为云现场展出的版本搭载16台计算柜、共计1024张昇腾卡。昇腾950超节点以单柜64卡为标准化起步配置,64个超节点还可以互联,构建巨型算力集群。
而中兴通讯的中兴OEX超节点采用OEX正交无背板设计实现零线缆互联,互联成本降低80%,重新定义智算新范式。
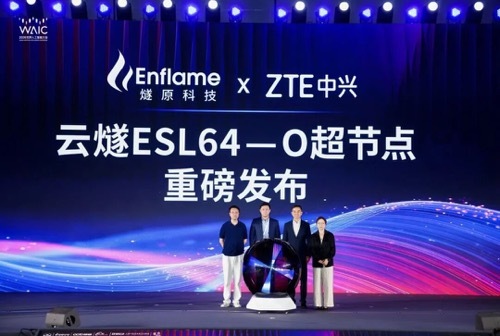
不同厂商之间还展开合纵连横。燧原科技也与中兴通讯、先封科技、星际天算分别发布云燧ESL64-O超节点、CoPoS+AI芯片、天基算力应用场景三项成果。
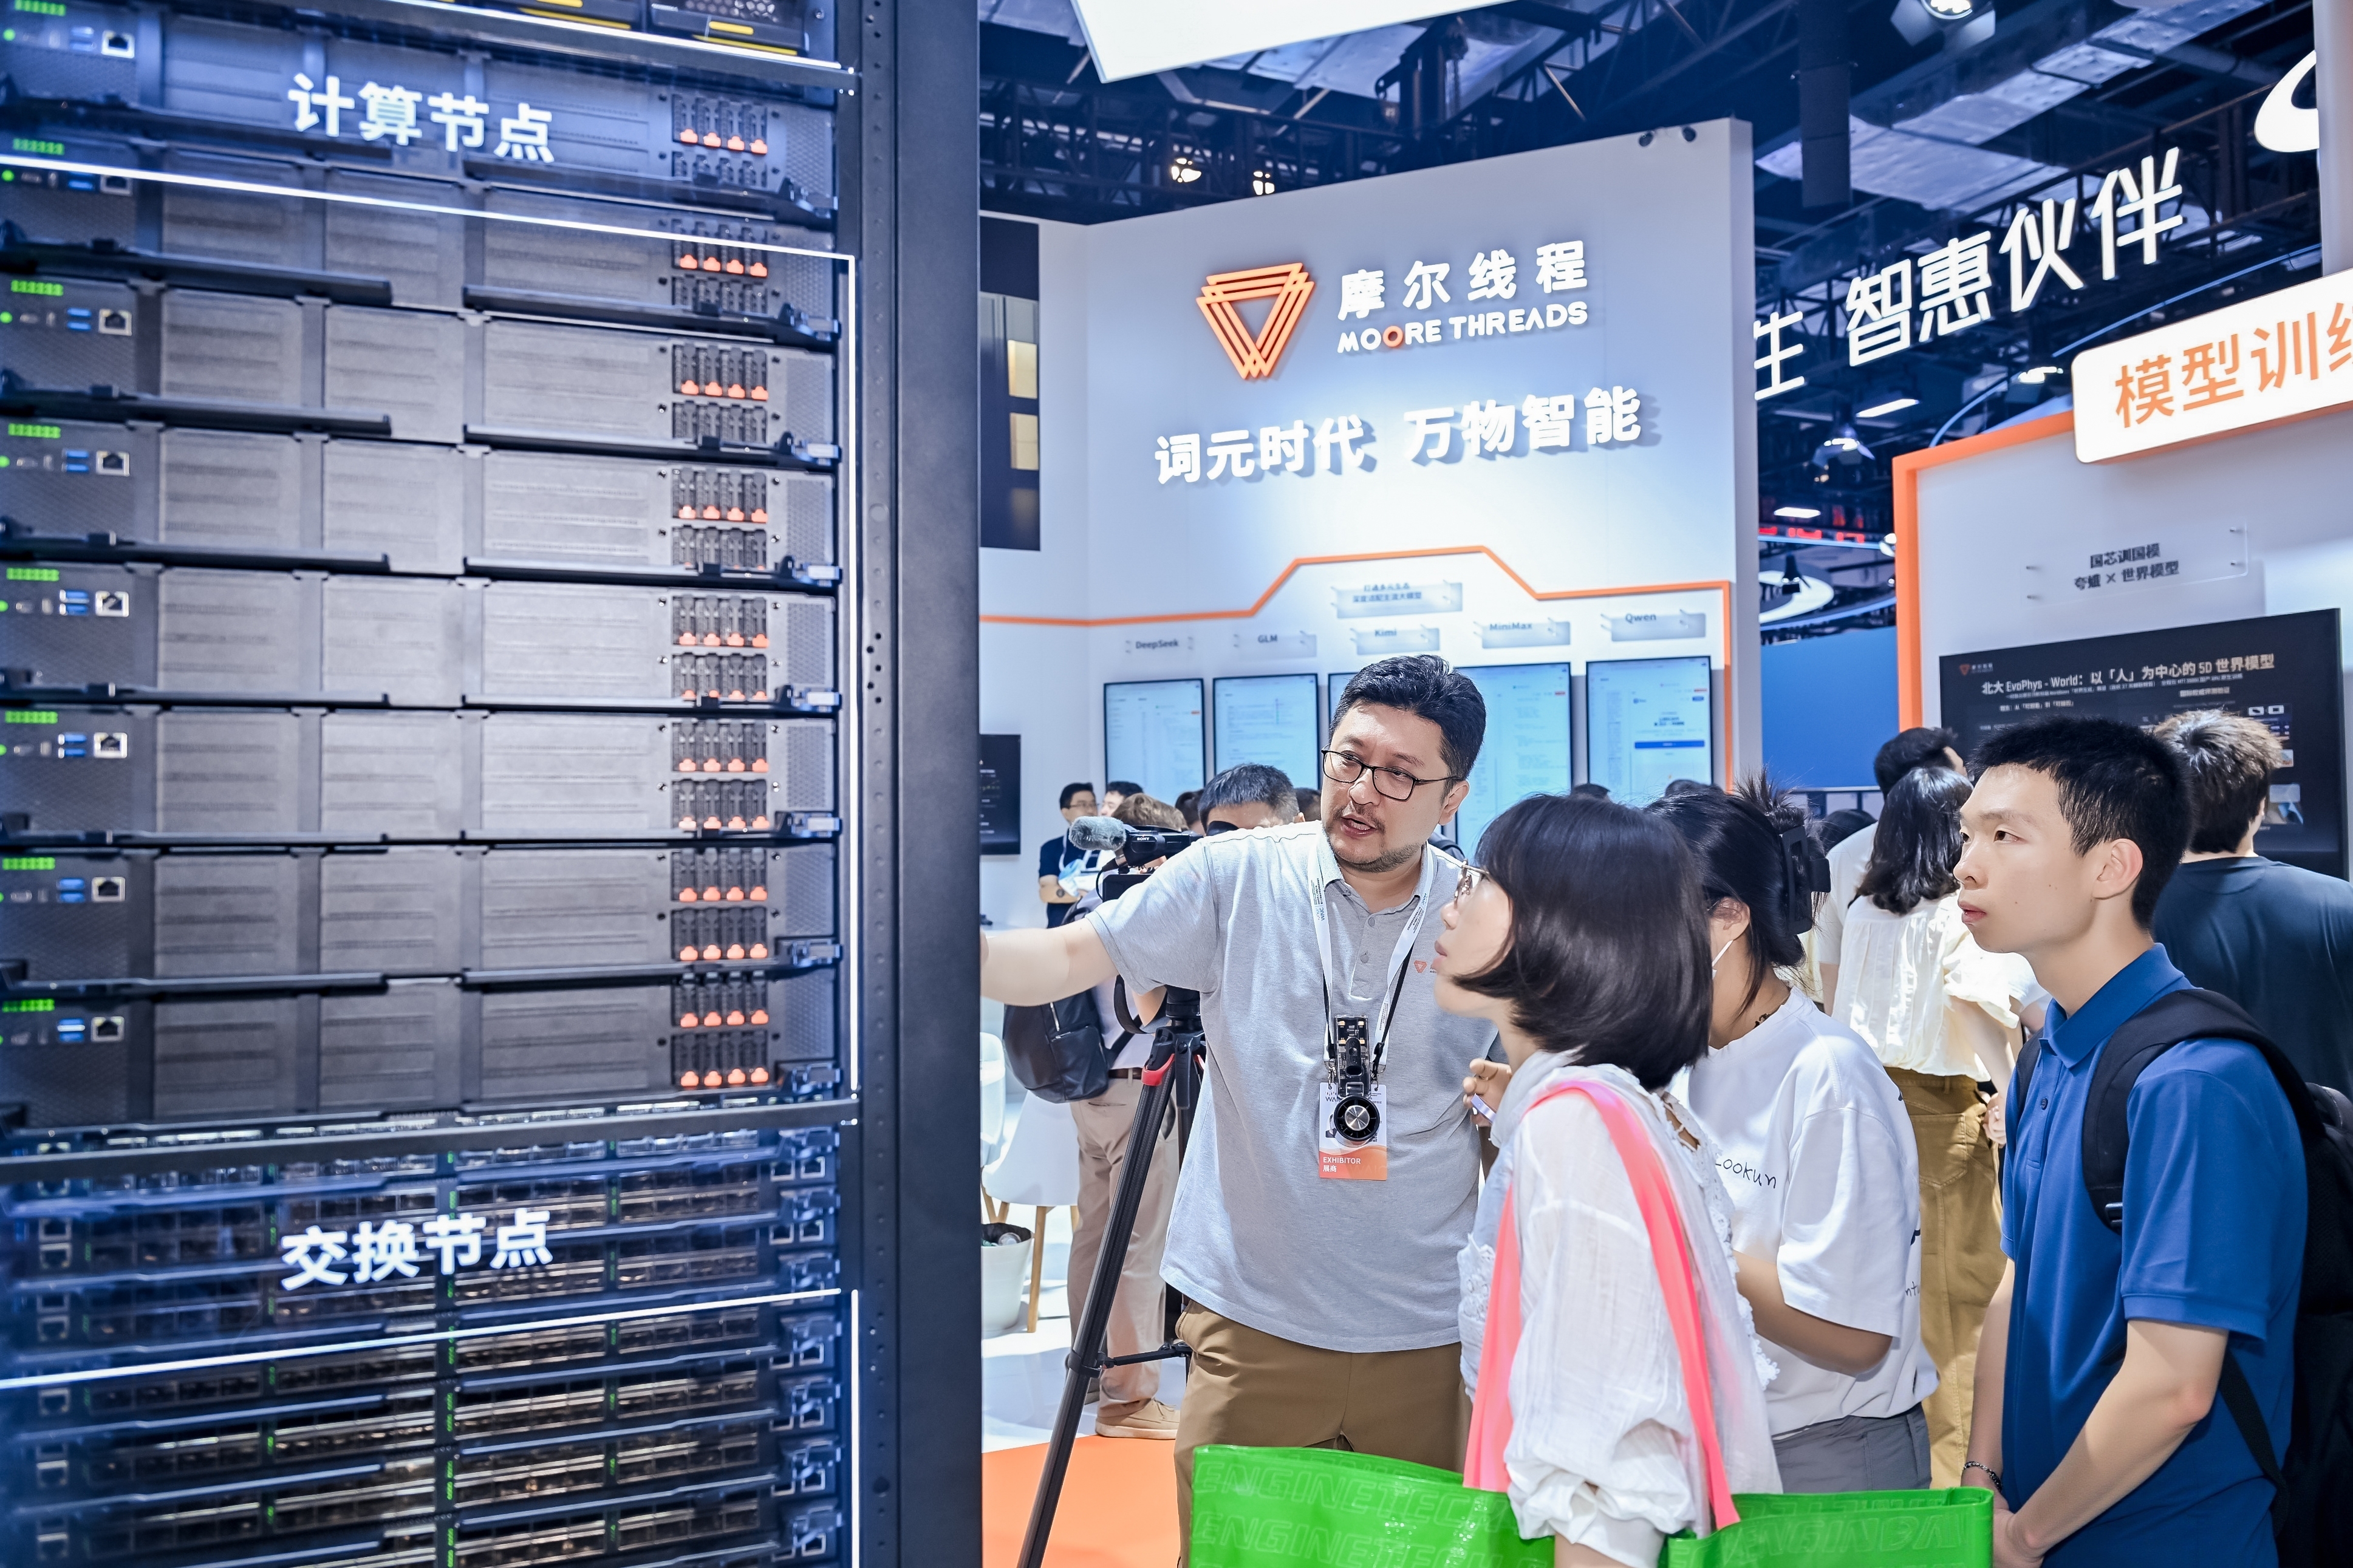
摩尔线程也是首次公开展示了其创新的MTT C256超节点,为万卡乃至十万卡级智算中心提供了全新的系统架构与算力底座。
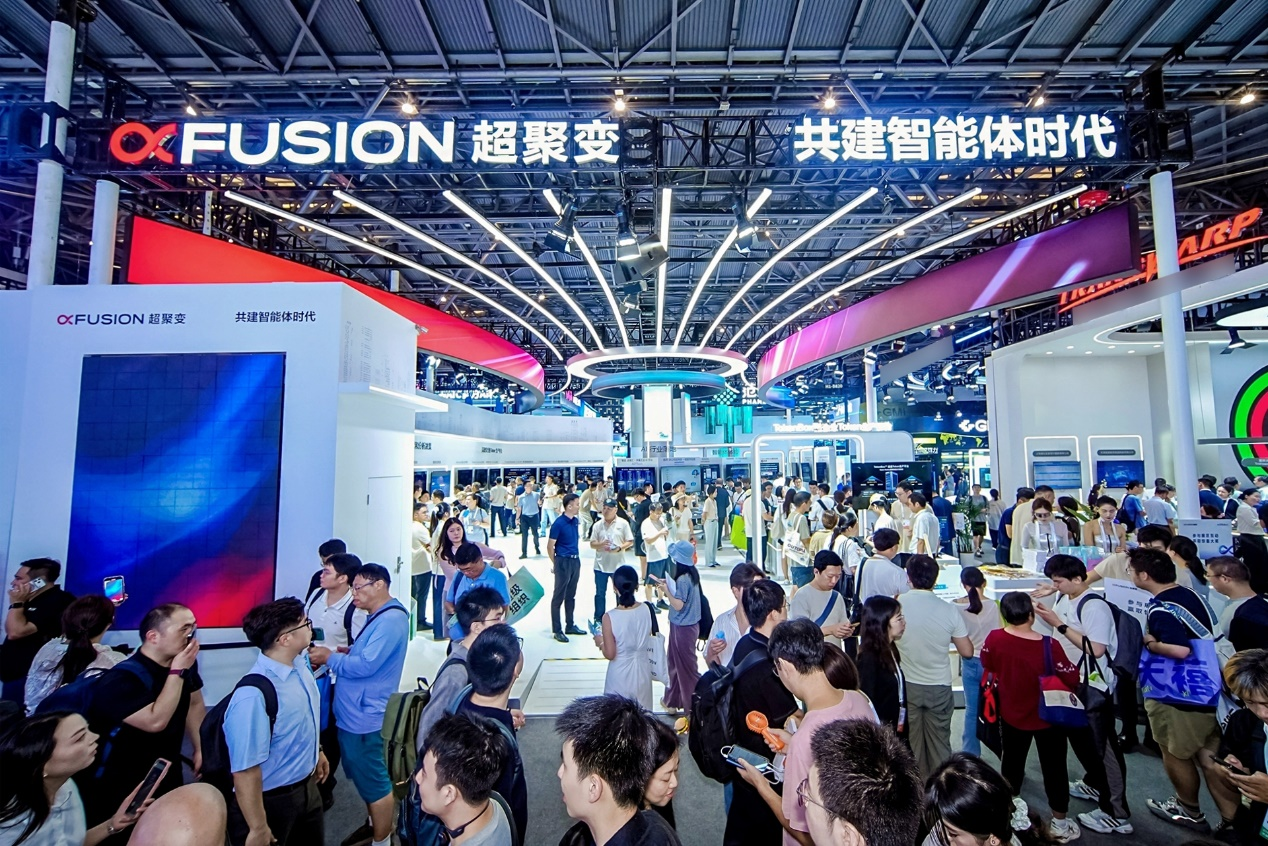
TokenBox™则是超聚变发布的“AI新物种”,它采用软硬一体设计,将原本更多属于数据中心的超节点能力带到企业业务现场,让高端算力以更可触达、更可部署、更可运营的方式进入企业。
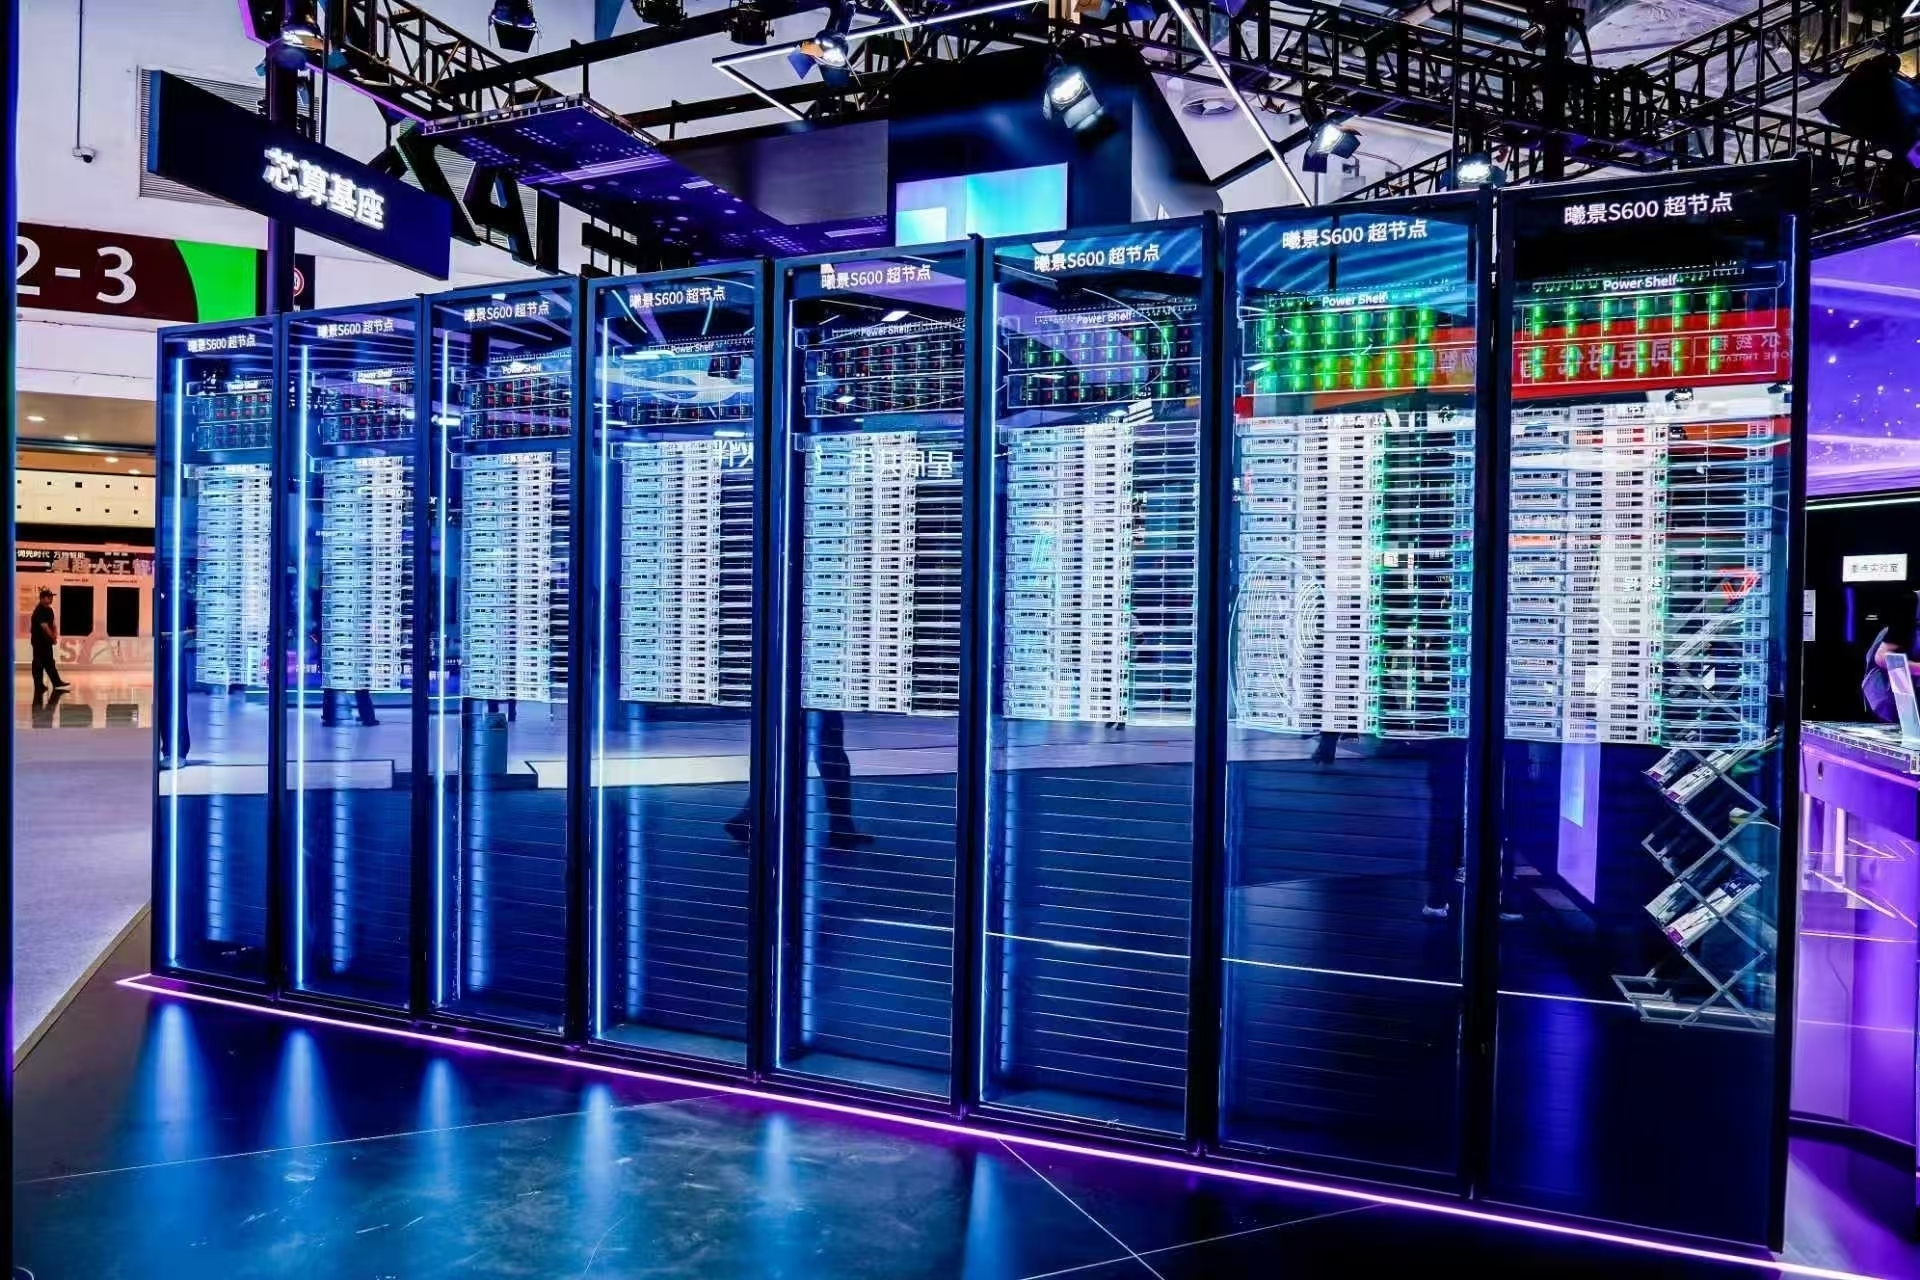
沐曦发布了新一代AI超节点产品——曦景S600,可实现单机柜64张GPU高速全互连,并支持灵活扩展至万卡级集群。
站在沐曦的视角剖析超节点产品优势,首先需要厘清一个核心认知:超节点绝非多块GPU硬件的简单堆叠,其底层设计逻辑完全围绕大模型训练、推理的规模化算力需求而生,是一套软硬件深度协同、一体化交付的完整系统方案。
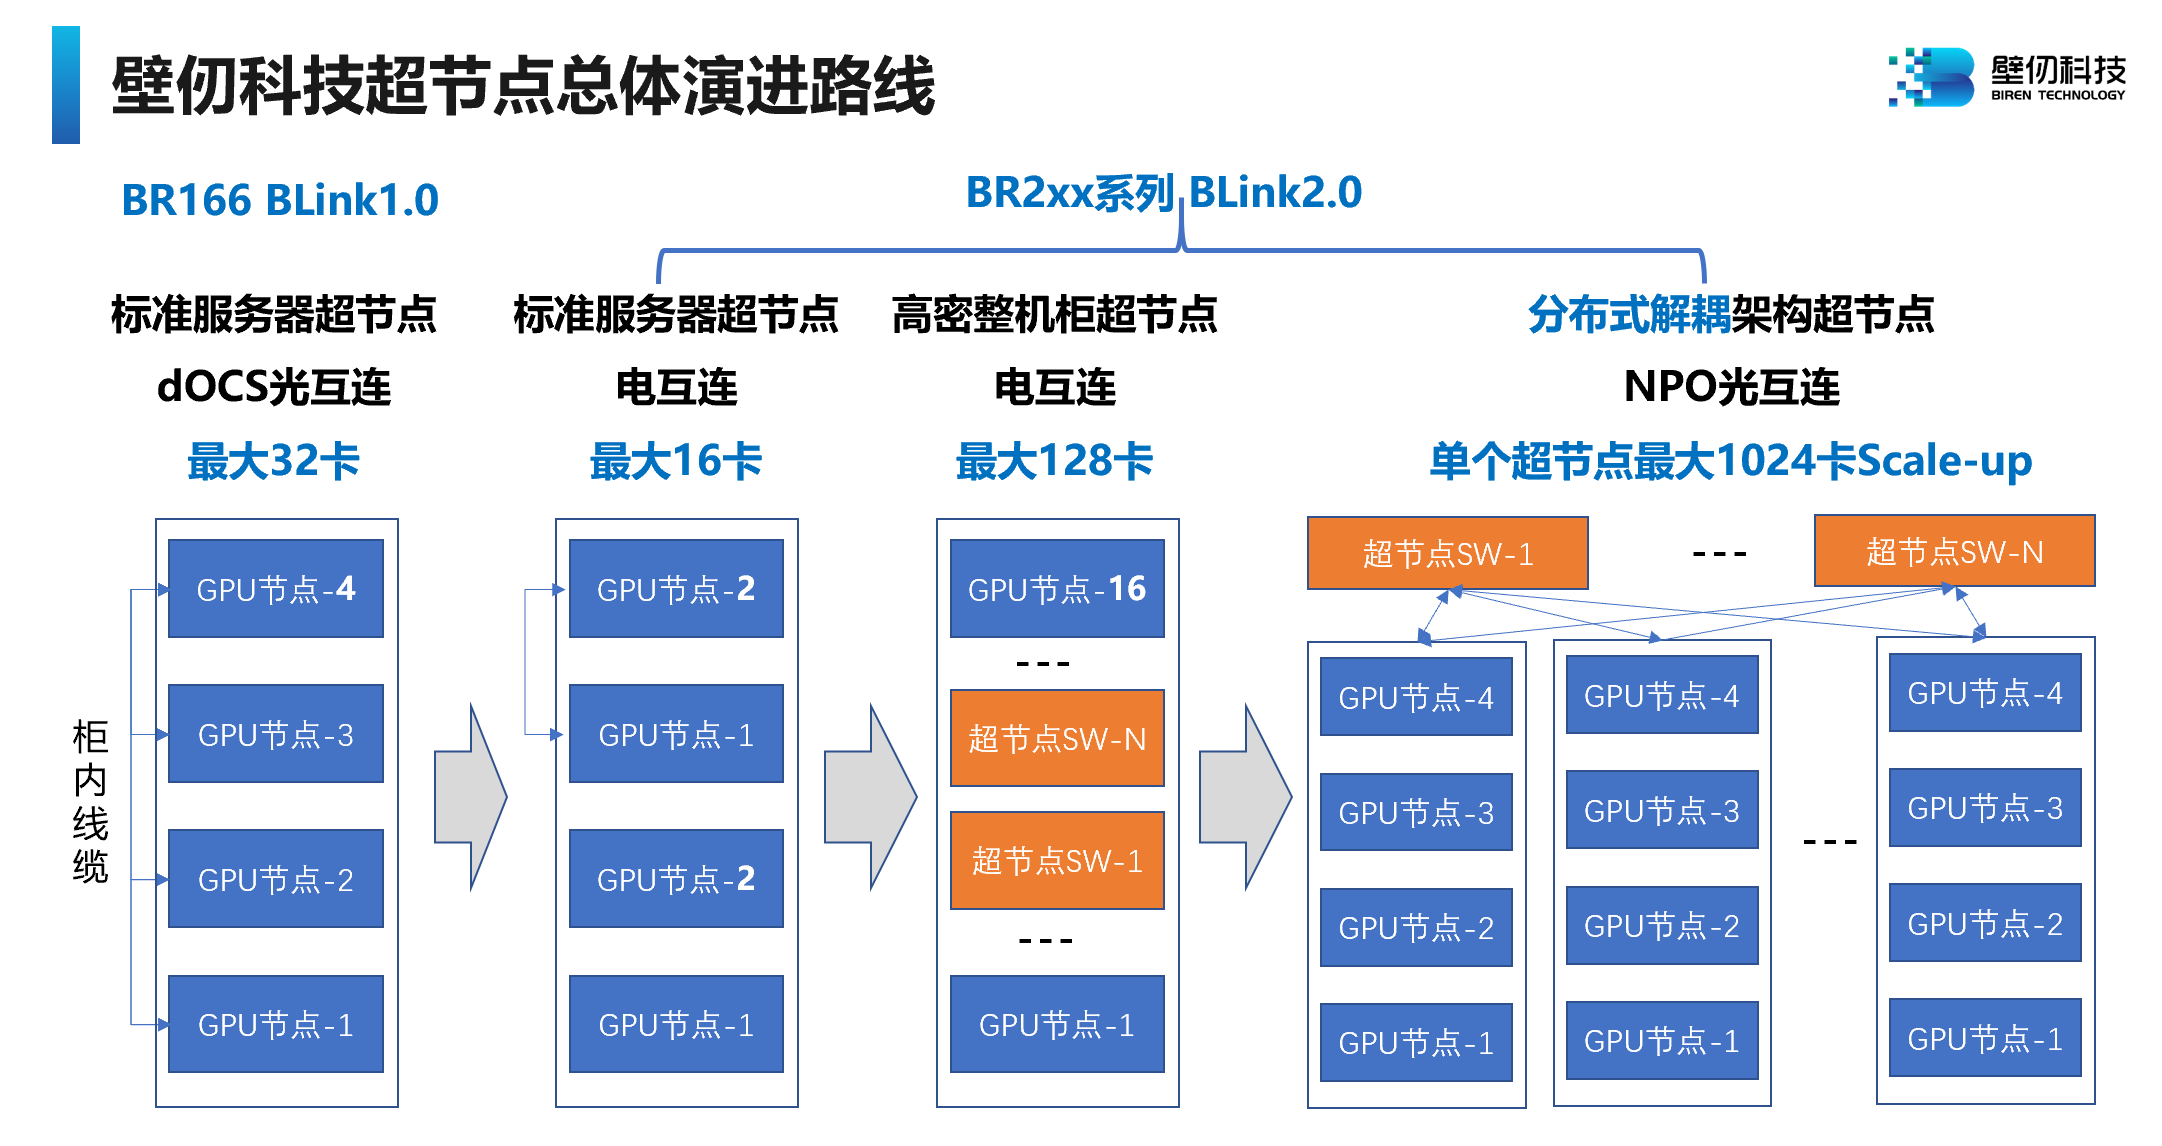
壁仞科技也给出了自己的方案推出下一代NPO光互连、分布式解耦架构超节点方案,支持单个超节点1024卡Scale-up扩展,推动国产算力从“单卡比拼”走向“集群系统竞争”的标志性突破。
昆仑芯超节点是国内率先实现量产交付的超节点产品之一,该产品采用自主研发的超高密度集成架构,单柜可集成32或64张加速卡,并支持扩展至512卡。
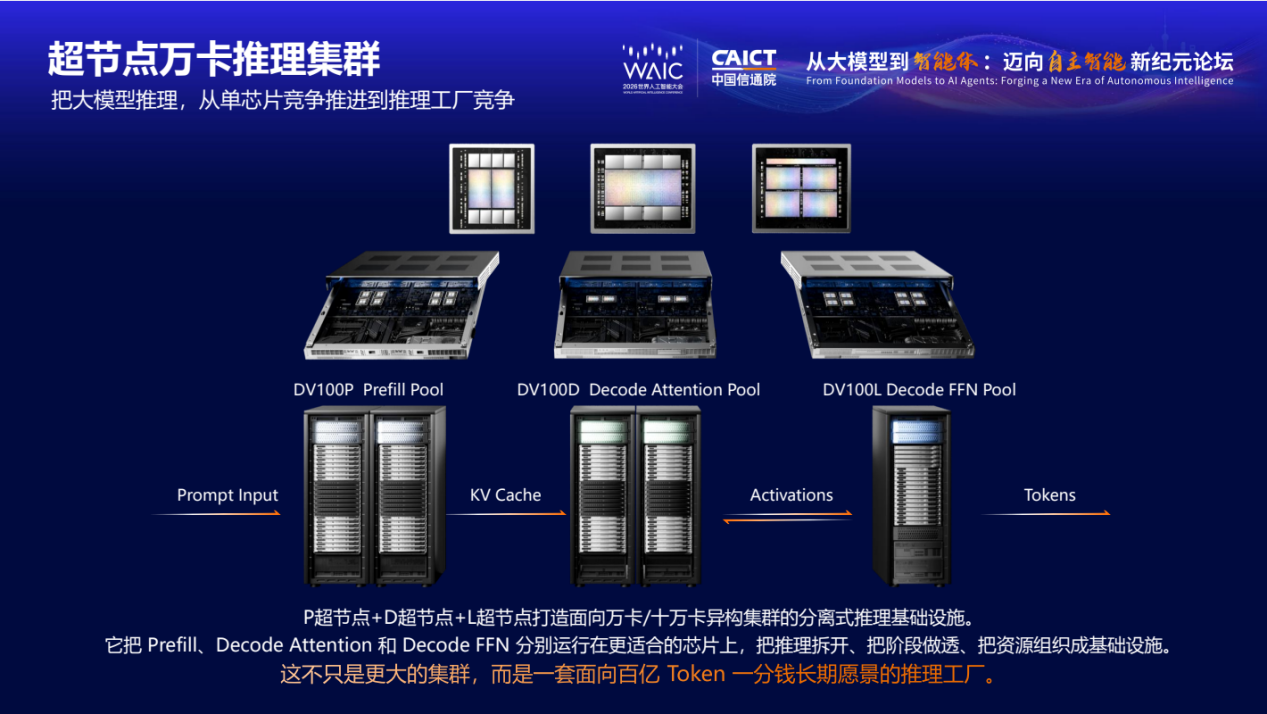
云天励飞则公布未来两年多AI推理芯片路线图,计划推出DeepVerse100P、DeepVerse100D、DeepVerse100L三款芯片,分别针对AI推理中Prefill、Decode和Decode FFN环节的负载特征进行专用优化。
三款芯片将面向万卡异构集群进行协同设计与部署,通过对不同推理阶段进行解耦,为不同负载配置更加适配的芯片和算力资源,进一步提升系统整体效率,持续降低Token生成成本。
有数据支持,2028年国产超节点市场空间规模有望达到3414亿元,而2026年至2028年复合年均增长率高达194%。
比拼系统工程创新能力
在AI行业的算力竞争中,单卡性能或不再是唯一标准,有效算力背后的整体系统工程已成为各大厂商比拼的新战场。
中科曙光就提到,实现十万卡规模高效运行,更考验超大规模集群背后的系统工程创新能力。曙光8000采用全球首创的高密度机柜结构,单个计算单元算力密度较其他超节点提升20倍,在有限空间内实现更高算力集成;同时采用自研scaleFabric类IB原生RDMA高速互连技术,实现十万卡规模超高速稳定互连,为超大规模并行计算和资源协同提供网络支撑。
壁仞科技首次推出NPO光互连、分布式解耦架构、最大1024卡超节点方案。
比如, 壁仞科技业界首创Chiplet(芯粒)架构大算力芯片,新一代BR2xx系列GPU延用这一技术路线。通俗地说,就是把多个计算芯粒像拼积木一样组合成一颗高算力芯片,突破单芯片制造的物理限制。
壁仞科技给出的不是单点技术突破,而是一套覆盖芯片、协议、系统、应用的超节点端到端解决方案。
摩尔线程推出的MTT C256超节点,用创新架构首创了一层Scale-up网络,旨在将256张GPU有效聚合为一台数据中心级超级计算机。
摩尔线程MTT C256超节点采用计算与交换一体化的高密设计,比如,突破业界普遍的一层网络64卡限制,MTT C256首次在一层Scale-up 网络中实现256卡全互联。这使得卡间通信延迟被压缩至亚微秒级,带宽利用率显著提升,为大模型分布式并行策略的优化提供了更广阔的空间。
在展馆内,多家几排黑色超节点机柜备受关注。但在清微智能,机柜外壳透明,内部密集排列的加速卡和液冷管路清晰可见,颇具设计感。
清微智能副总裁陈逸伦提到,清微下一代TX82 3D芯片相当于把原来二维平面的连接变成三维连接,就好比从单车道一下拓宽成四车道,数据跑起来完全不堵车。RAISA软件栈支持200多款大模型和十余类应用,用户基本可以做到开箱即用。”
TokenBox™单机则可支持满血版DeepSeek V4 1.6T旗舰大模型,并基于TokenFabric™实现从单机到多节点的高效互联。结合FusionOne AI的软件能力,TokenBox™进一步打通模型部署、推理加速、智能体执行、体验保障和运营管理等关键链路,帮助企业本地AI建设从“部署设备”走向“运营AI生产力”。
这种“蚂蚁啃大象”的战术,诠释了中国工程师的智慧:既然单打独斗难以取胜,就用系统级创新弥补个体差距。
搭生态加速千行百业应用
在科技产业的演进中,技术突破往往被视为创新的核心,但构建可持续的生态系统才是更深层的挑战。
鲜为人知的是,充满未来感的2026年世界人工智能大会官方主题曲《共创未来》,并非出自人类音乐家之手,而是由国内新锐大模型公司自由量级自研的“音潮V3.5”全流程AI生成,实现了从词曲创作、编曲混音到人声演唱的“零人工”介入。
自由量级研发团队透露,此前受全球算力市场波动影响,团队曾面临GPU供应短缺、模型迭代放缓的困境。在迁移至壁仞科技壁砺™166L平台后,这一局面得到扭转。壁砺™166系列作为大算力训推一体芯片,不仅兼容原有基于海外GPU的开发环境,实现了平滑迁移,更凭借出色的性价比,支撑团队在有限预算内开展了更大规模的算法探索。
这是国产算力在垂直大模型领域的商业化落地的一个缩影。在此次展会上,各大企业纷纷展示应用成果。
清微智能展示了可重构算力已实现多场景落地。在航天领域,自研芯片通过15G重力极限压力测试,计划年底完成卫星在轨试验方案,可实现太空数据就地采集、就地运算、回传结果。
在产业赋能领域,依托国内算力枢纽节点布局的智算中心,落地AI智能探矿应用,将传统探矿的试错式作业升级为精准预判,探矿效率大幅提升。
而昆仑芯的产品则已广泛应用于互联网、大模型、运营商、金融、能源电力、智能终端、智能驾驶等关键领域,为众多行业客户提供稳定、高效的AI算力支撑,市场份额在国产AI加速卡中稳居前列。
昆仑芯通过真实客户案例与应用场景,围绕互联网、运营商、政企、终端及万卡集群等重点行业,集中展示了从核心技术突破到产业规模落地的实践成果。
曙光8000已依托国家超算互联网接入全国一体化算力网,完成300余项重点应用优化,覆盖大模型、机器人、创新药、新材料、量子计算、天文气象等20余个科研和产业领域,超过70项应用实现万卡规模扩展,并支撑蛋白质折叠模拟、万亿原子级水分子动力学模拟、超大规模湍流模拟等科学智能应用,以及大模型训练、科学智能体和行业智能体等人工智能应用持续运行。
开放,成为这些厂商最频频提及的关键词。在云天励飞的规划中,IFWA软件栈并非一套封闭的软件体系,而是通过对主流模型、框架和开发工具的兼容,降低开发者的迁移和使用成本,缩短模型在DeepVerse平台上的部署周期,让国产算力更加便捷地进入实际应用。
随着人工智能持续迈向科学智能、行业智能体和物理AI等更复杂场景,超大规模算力系统正由支撑模型训练进一步走向支撑科研创新和产业智能。
南方+记者 郜小平中国股票配资企业
文章为作者独立观点,不代表联华证券-线上股票配资实盘-十大正规股票配资软件观点
相关文章